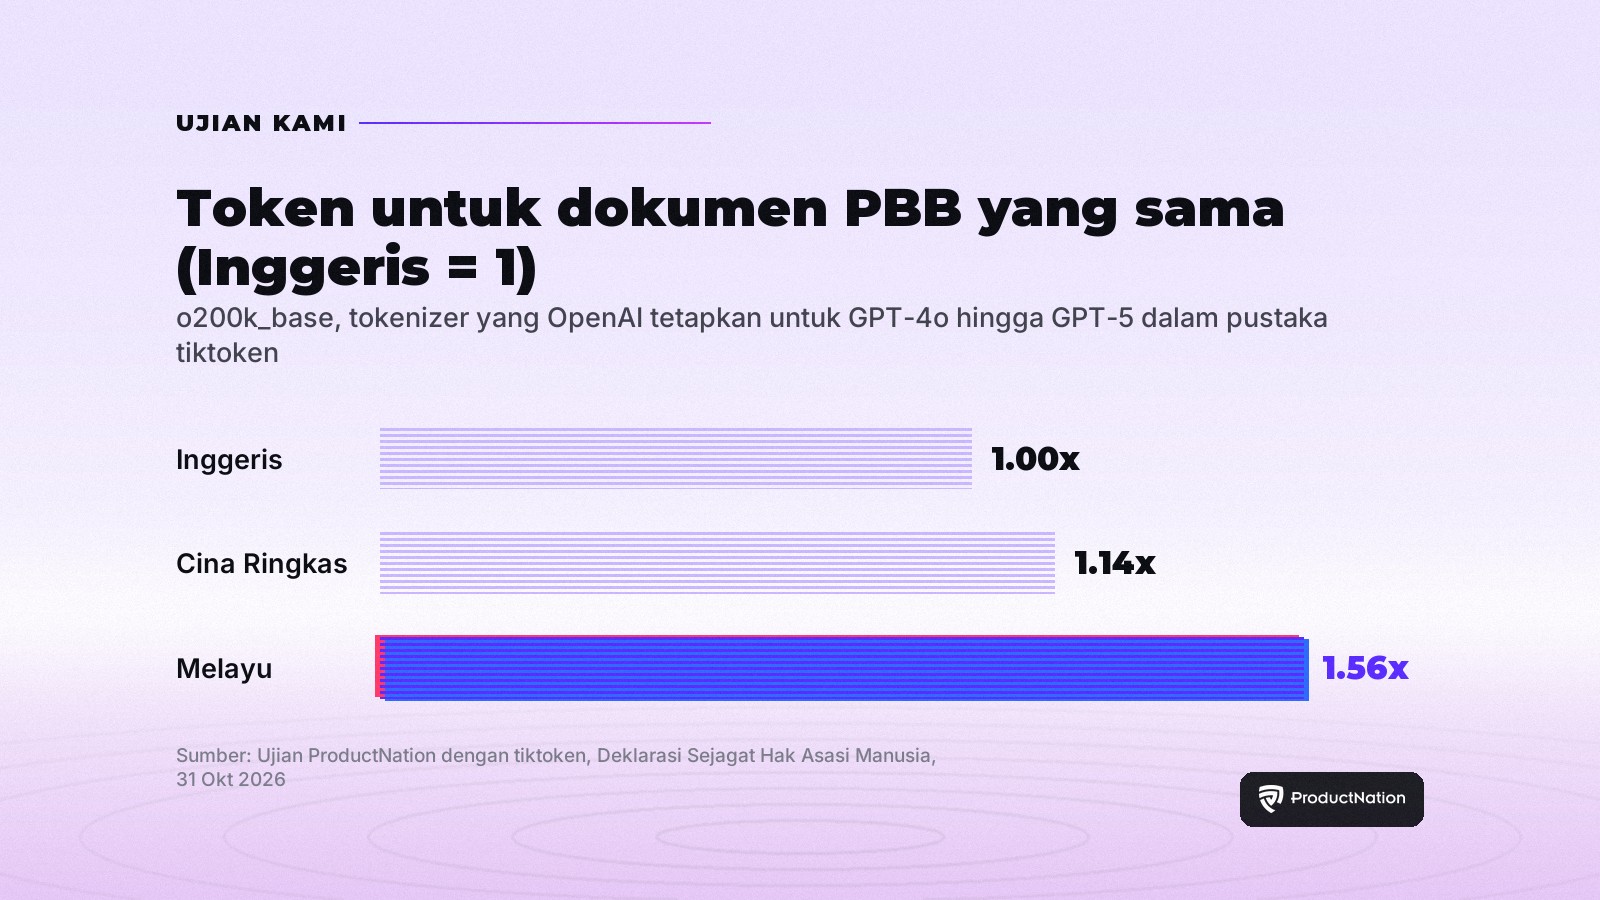
Kami masukkan dokumen yang sama ke dalam tokenizer OpenAI dalam bahasa Inggeris, Melayu dan Cina Ringkas, menggunakan terjemahan rasmi PBB sendiri. Versi bahasa Melayu menggunakan 56% lebih banyak token berbanding versi bahasa Inggeris. Pada API OpenAI, yang mengenakan caj mengikut token, ini bermakna pada model dan harga token yang sama, kandungan yang sama dalam terjemahan bahasa Melayu PBB kos lebih tinggi untuk diproses berbanding bahasa Inggeris.
Kandungan
Fakta ringkas
- Terjemahan bahasa Melayu memerlukan 1.56 kali token versi bahasa Inggeris pada o200k_base, tokenizer yang ditetapkan oleh pustaka sumber terbuka tiktoken milik OpenAI untuk GPT-4o hingga GPT-5.
- Terjemahan Cina Ringkas memerlukan 1.14 kali.
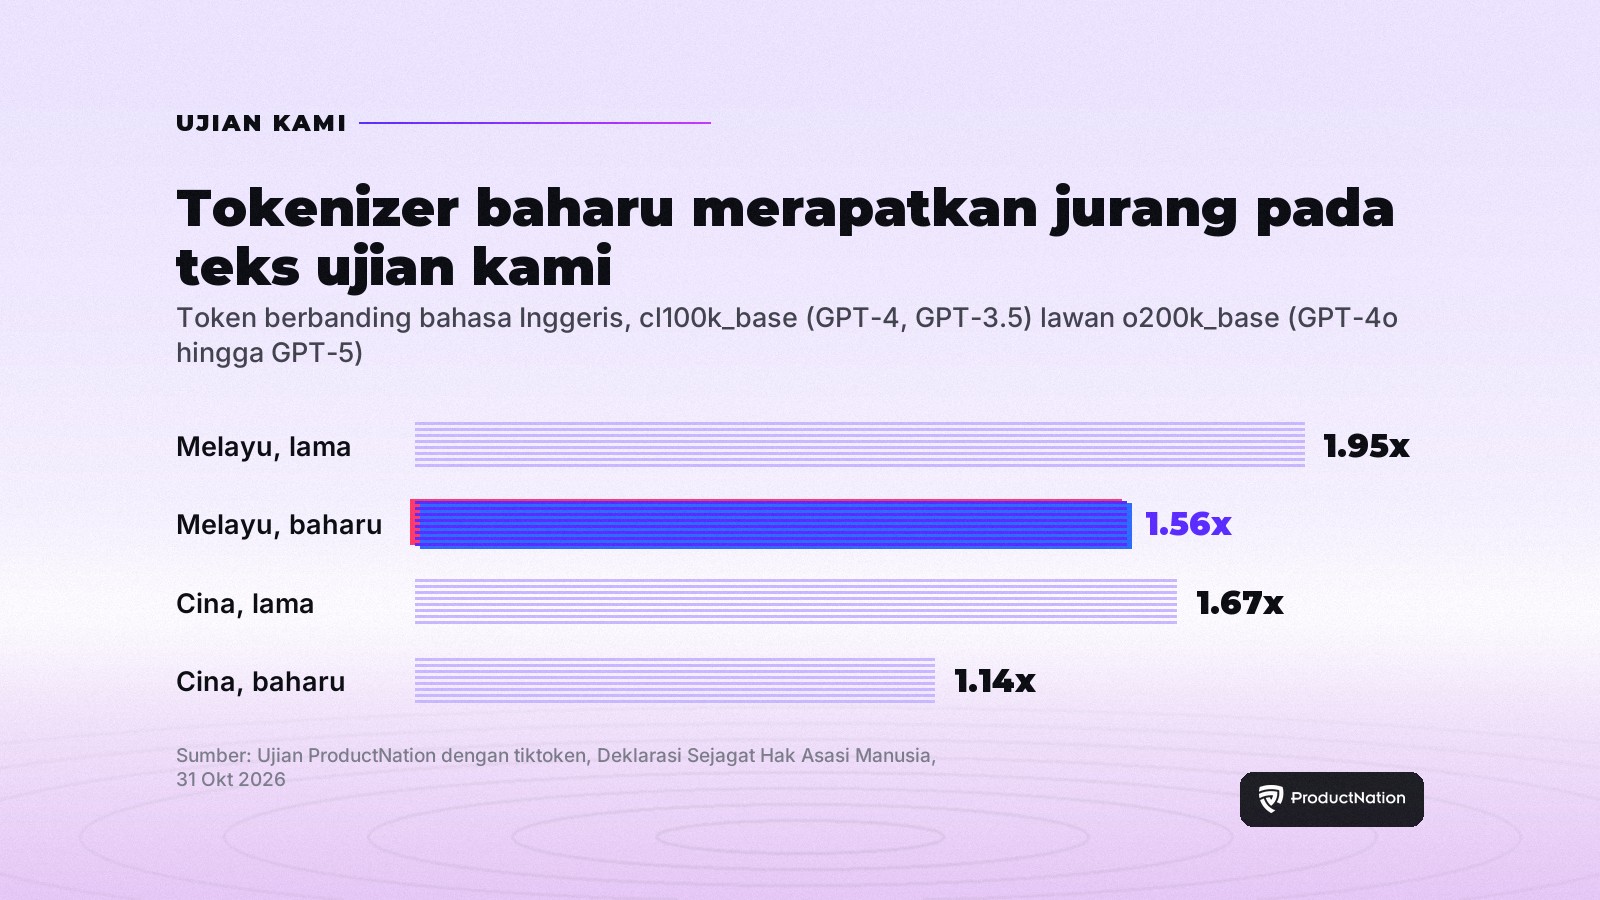
- Pada cl100k_base, tokenizer lama yang digunakan oleh GPT-4 dan GPT-3.5, teks bahasa Melayu memerlukan 1.95 kali.
- Teks ujian: mukadimah dan 30 perkara Deklarasi Sejagat Hak Asasi Manusia, dalam terjemahan yang disemak dengan salinan pejabat hak asasi manusia PBB sendiri.
Apa yang kami ukur
Model AI tidak membaca perkataan. Ia membaca token, iaitu cebisan kecil teks, dan senarai harga API OpenAI dinyatakan bagi setiap sejuta token. Teks yang terpecah kepada lebih banyak token kos lebih tinggi untuk dihantar dan memenuhkan lebih banyak ruang konteks model.
Rest of World melaporkan pada 26 Oktober bahawa penyelidik memanggil ini "cukai tokenizer". Laporannya tidak membincangkan bahasa Melayu atau Cina, jadi kami mengukurnya sendiri.
Kami menggunakan tiktoken, pustaka tokenizer yang diterbitkan OpenAI, pada Deklarasi Sejagat Hak Asasi Manusia. Salinan digital kami diambil daripada koleksi penyelidikan NLTK, dan kami menyemak setiap satu dengan terjemahan PDF pejabat hak asasi manusia PBB sendiri. Perbandingan kesamaan teks memberikan skor antara 98.4% dan 99.7%, dengan perbezaan hanya pada pengepala halaman dan penomboran. Kami mengira dari mukadimah hingga Perkara 30 dan tidak memasukkan tajuk serta pengenalan.
Maksudnya dalam ringgit
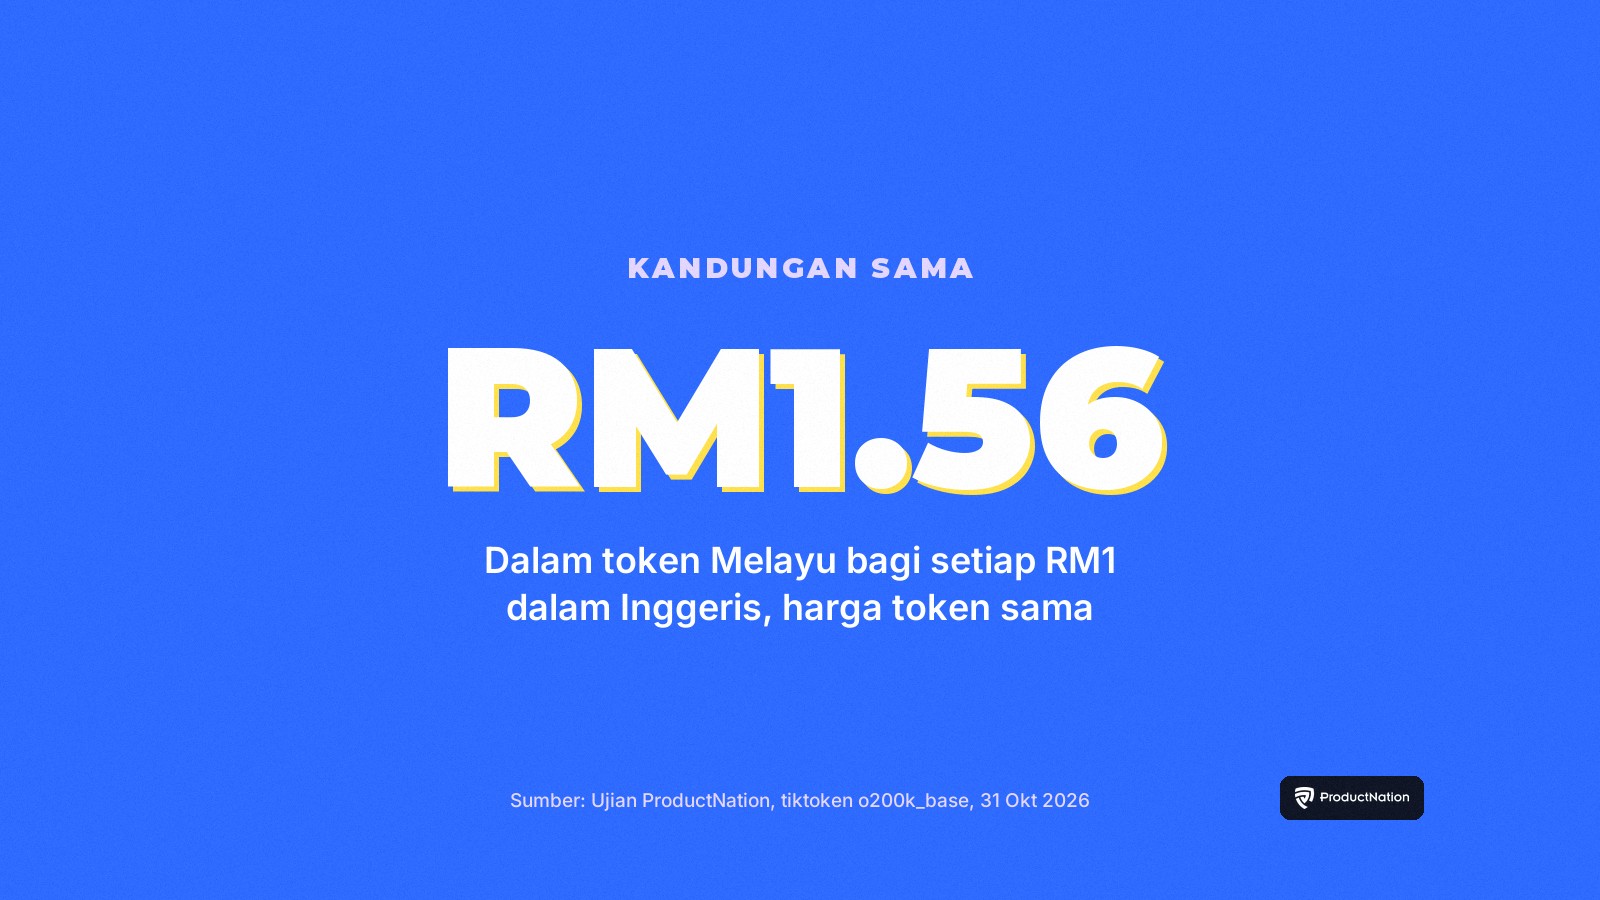
Versi bahasa Inggeris mengambil 1,971 token. Bahasa Melayu mengambil 3,069. Cina Ringkas mengambil 2,244. Pada harga token yang sama, setiap RM1 yang dibelanjakan untuk memproses versi bahasa Inggeris akan menjadi kira-kira RM1.56 untuk terjemahan bahasa Melayu dan RM1.14 untuk terjemahan Cina.
Bahasa Melayu menggunakan abjad Latin yang sama seperti bahasa Inggeris, jadi tulisan sahaja nampaknya bukan punca utama. Bacaan kami ialah perkataan Melayu yang lebih panjang, seperti "pengiktirafan" dan "kebebasan", dipecahkan kepada lebih banyak cebisan. Itu tafsiran kami, bukan sesuatu yang diukur oleh ujian ini.
Tokenizer lama lawan baharu
Pada dokumen ini, o200k_base menghasilkan jurang yang lebih kecil berbanding cl100k_base, tokenizer di sebalik GPT-4 dan GPT-3.5 yang lebih lama. Bahasa Melayu turun dari 1.95 kepada 1.56 kali bahasa Inggeris, dan Cina dari 1.67 kepada 1.14 kali.
Apa yang tidak kami uji
Ujian ini meliputi dua tokenizer OpenAI sahaja, dan pustaka tiktoken OpenAI tidak menyatakan tokenizer yang digunakan oleh model terbaharunya. Gemini milik Google, yang seperti kami laporkan menjual pelan AI di Malaysia dari RM23.99 dan menawarkan model satu juta token di sini, serta Claude milik Anthropic tidak diuji, jadi angka mereka mungkin berbeza. Kami tidak memasukkan bahasa Tamil: salinan dalam koleksi penyelidikan itu ialah terjemahan yang berbeza daripada versi semasa pejabat PBB, dan PDF Tamil PBB tidak boleh diekstrak sebagai teks, jadi kami tidak dapat mengukur teks rasminya. Kami mengukur teks yang dimasukkan, bukan jawapan model, kelajuan respons, arahan sistem atau bil bulanan penuh, dan pelanggan ChatGPT pada pelan bulanan tetap tidak membayar mengikut token langsung. Satu dokumen rasmi juga hanya satu sampel: bahasa Melayu sembang harian, yang penuh dengan pinjaman bahasa Inggeris dan singkatan, mungkin terpecah secara berbeza.